Semua karya
01 / 06
Studi kasus
Jawi OCR
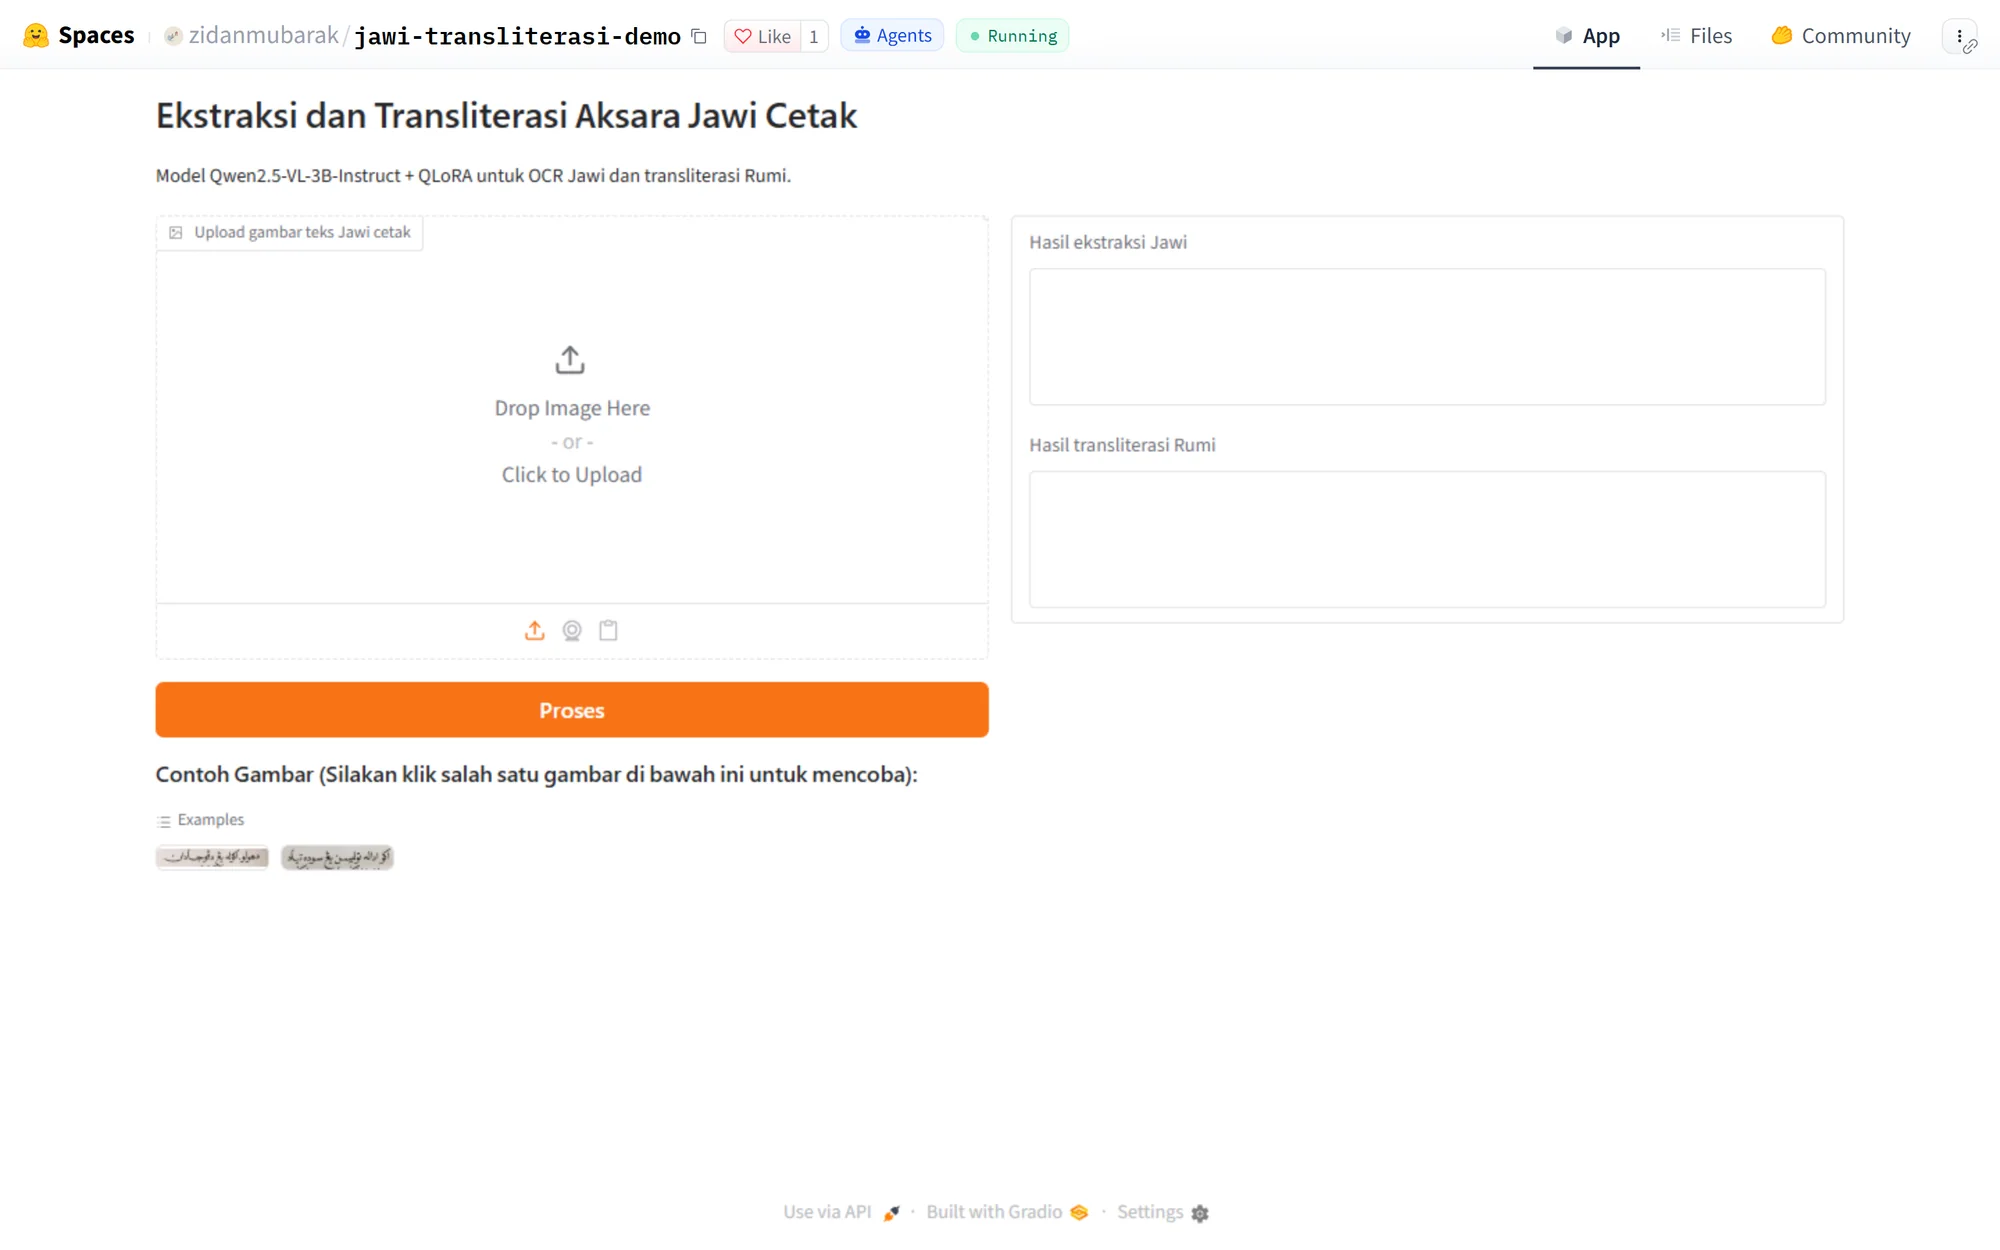
Fine-tuning Qwen2.5-VL-3B untuk mengekstraksi aksara Jawi dan mentransliterasinya ke Rumi, dengan kedua tahap dievaluasi secara terpisah.
- Peran
- Peneliti dan ML engineer (solo)
- Tahun
- 2026
- Stack
- Qwen2.5-VL-3B · QLoRA · Unsloth · PyTorch · Hugging Face · Gradio
- Waktu baca
- 6 menit
- Tim
- Skripsi sarjana, UIN Ar-Raniry
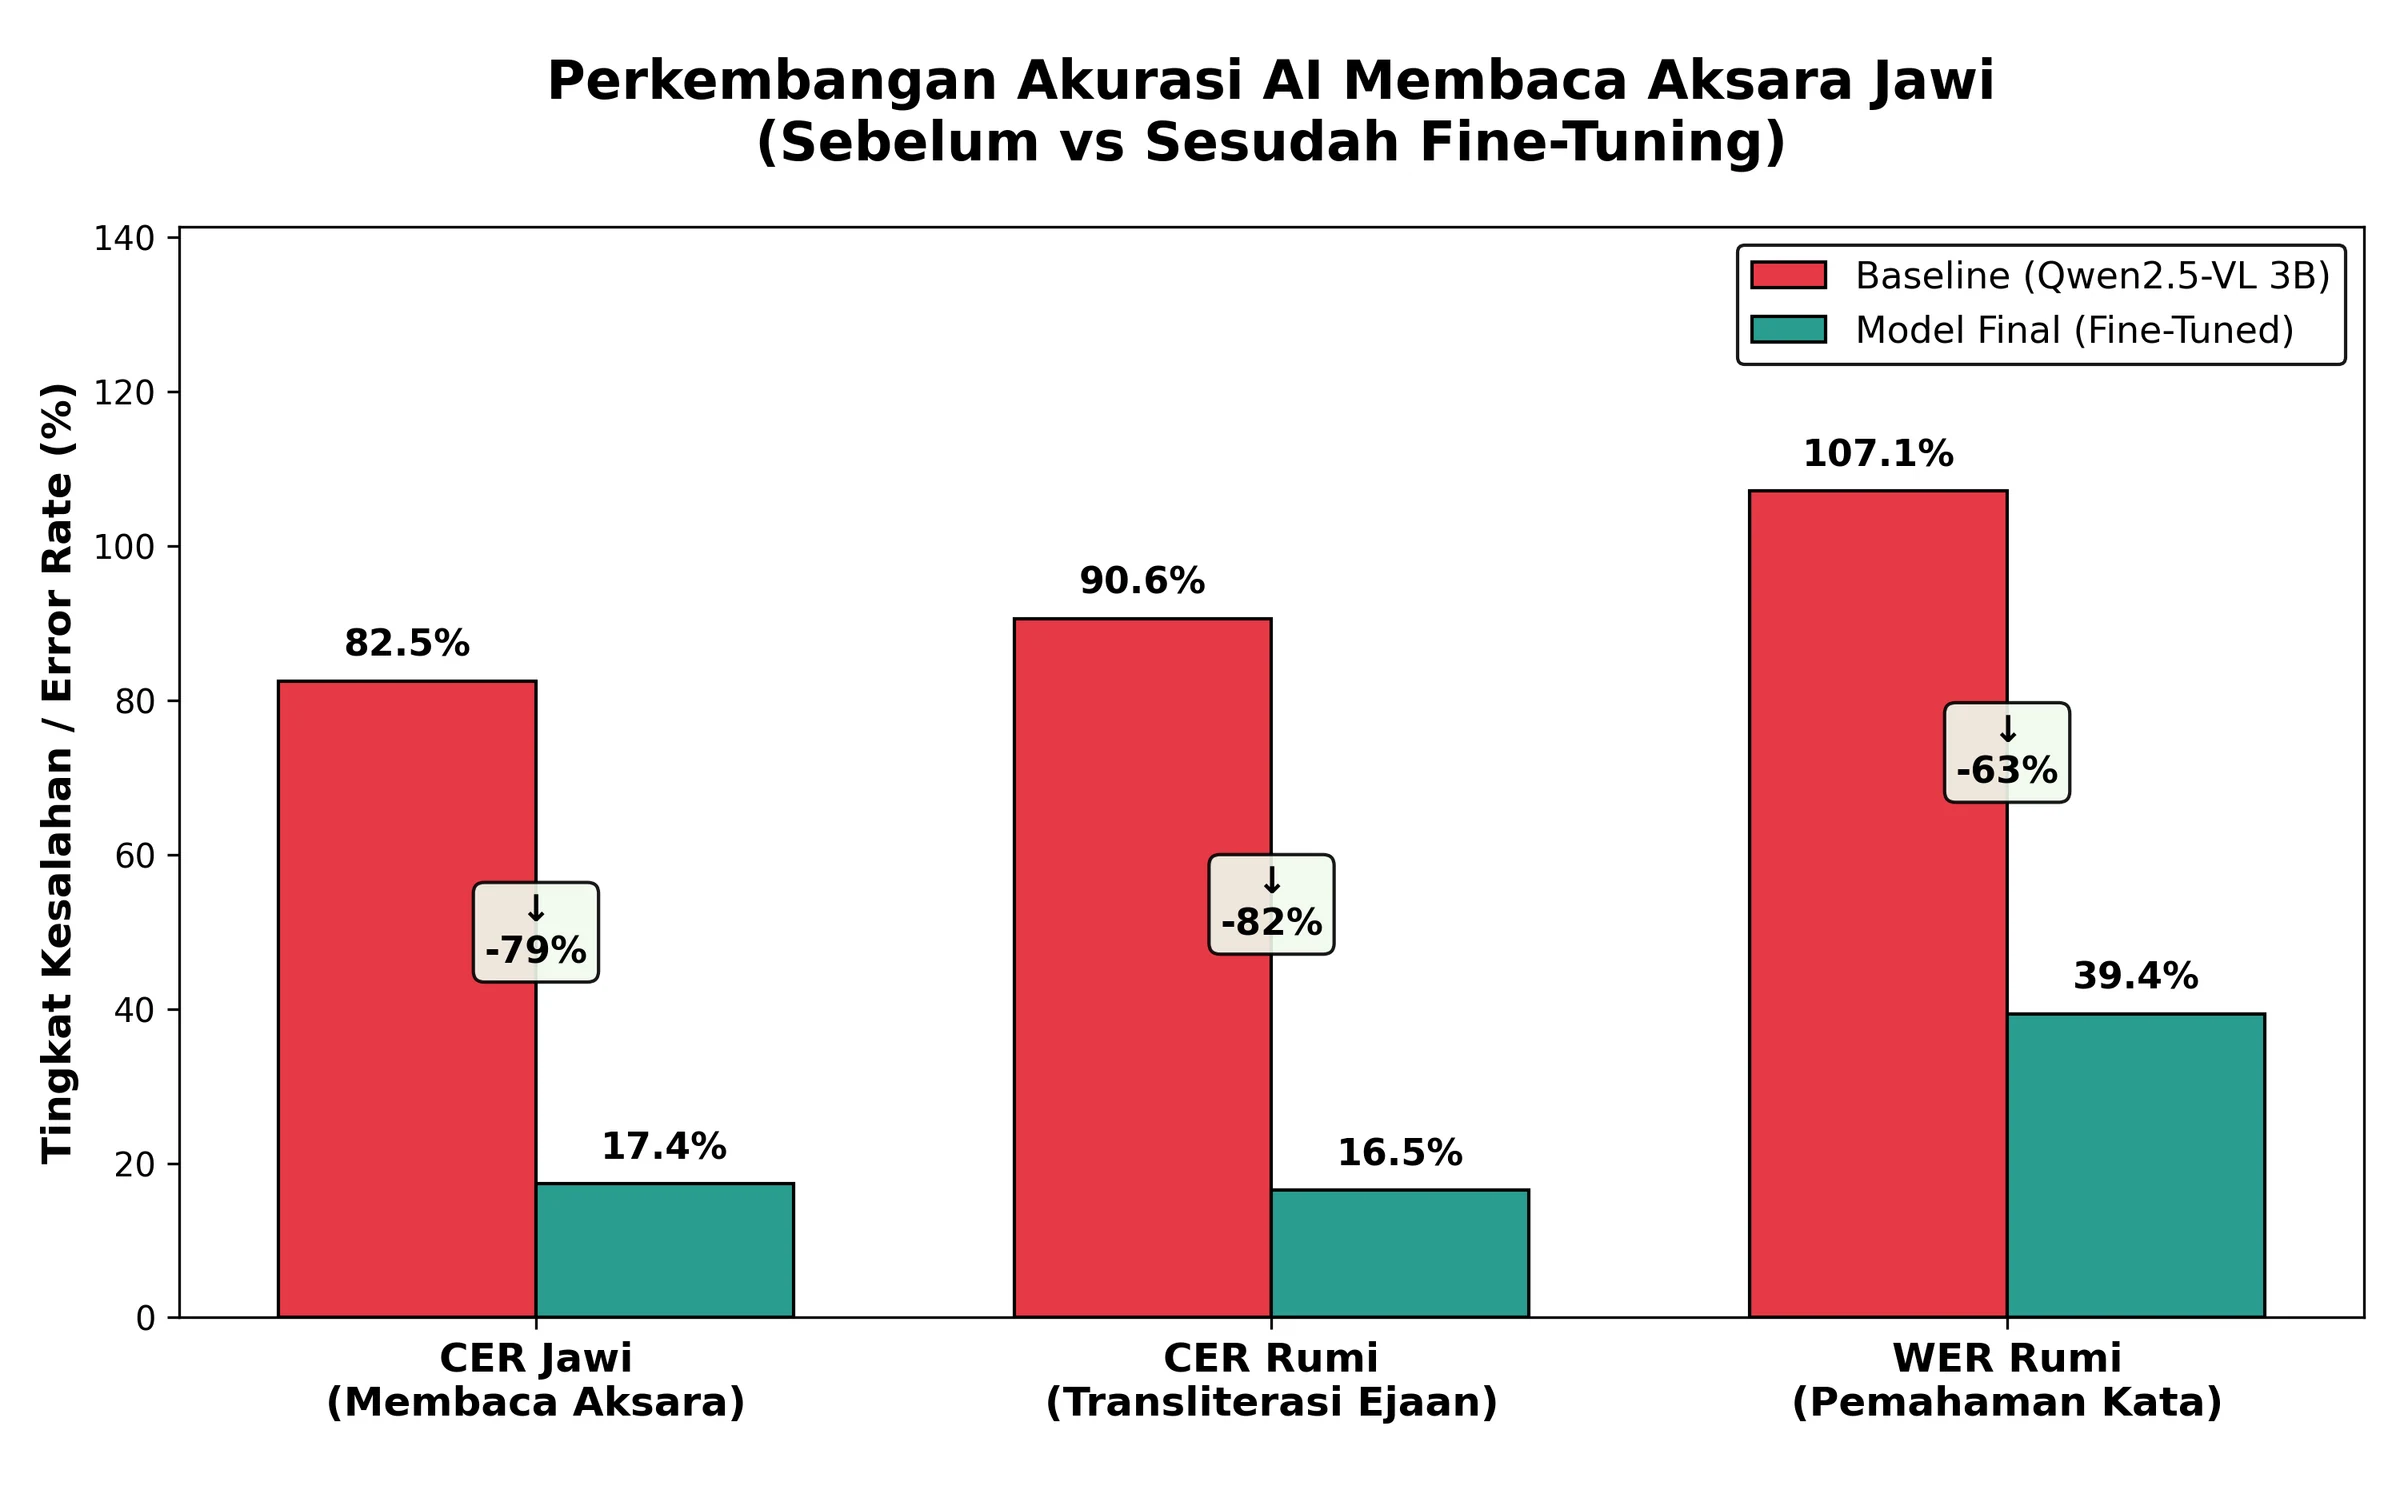
Hasil
lebih sedikit character error
CER Jawi: 82,51% → 17,35% pada 790 citra held-out
Yang saya ambil
- 01
Skenario gabungan menang: font saja tidak mencakup dokumen nyata, dan dokumen saja tidak mencakup variasi yang cukup.
- 02
Nilai setiap tahap secara terpisah, karena skor Rumi yang lumayan bisa menyembunyikan ekstraksi yang buruk di bawahnya.
- 03
Pilih checkpoint yang bisa generalisasi, bukan yang training loss-nya paling rendah.
- 04
Rilis demo bersama metriknya; perbandingan berdampingan itulah yang membuat peningkatan terbaca.
Di mana masih gagal
- Word error rate 39,36% pada transliterasi berarti manusia masih harus meninjau keluarannya.
- Model card memperingatkan bahwa blur, cropping, dan noise latar yang berat menaikkan CER.
- Tulisan tangan kursif yang sudah sangat tua lebih sulit daripada typesetting cetak; cakupan skripsi adalah Jawi cetak.
- PEJYD punya pengecualian untuk kata serapan Arab yang masih bisa salah ditebak model.
- 790 citra uji tergolong kecil untuk standar OCR; baca angka ini sebagai estimasi.
Sumber
- CV - Zidan Mubarak (ekspor Google Docs, diperbarui 29 Okt 2026)Buka (terbuka di tab baru)
- Model card Hugging Face - zidanmubarak/jawi-qwen25-vl-qloraBuka (terbuka di tab baru)
- Berkas model Hugging Face - adapter dan grafik showcaseBuka (terbuka di tab baru)
- Hugging Face Space - jawi-transliterasi-demo (Gradio)Buka (terbuka di tab baru)